Como é uma boa IDE de banco de dados em 2026
Bom não é uma lista de funcionalidades. Uma IDE de banco de dados é boa quando conhece o banco ao qual está conectada — versão, schema, restrições — e se adapta.
Bom não é uma lista de funcionalidades.
Quando uma empresa de ferramentas para desenvolvedores diz que o produto é “bom”, geralmente significa que foi lançado recentemente, tem modo escuro e integra com algo que bombou no Hacker News. Essa definição funciona para um editor de texto. Para uma IDE de banco de dados, nem é ponto de partida.
Uma IDE de banco de dados é boa quando conhece o banco de dados ao qual está conectada. Não bancos de dados em geral. Não a versão mais recente. O banco de dados específico — a versão rodando no seu servidor, o schema na conta do usuário conectado, os objetos que realmente existem.
Esse é um problema mais difícil do que parece.
A maioria das IDEs em 2026 trata o banco de dados como um pano de fundo. Você digita SQL, a ferramenta envia, o banco executa ou reclama. A ferramenta não tem modelo do que o banco contém. Não consegue alertar, antes de executar, que uma consulta vai fazer varredura completa em uma tabela de 200 milhões de linhas sem índice. Não sabe que a coluna que você está referenciando foi renomeada três migrações atrás. Não distingue entre “esta sintaxe é Oracle válido” e “esta sintaxe é Oracle válido na versão que você está usando”.
Se a ferramenta adiciona uma camada de IA por cima dessa arquitetura, você ganha um autocompletar mais sofisticado que ainda não conhece seu schema. Ele adivinha. Às vezes acerta. No restante do tempo, alucina nomes de colunas, gera sintaxe válida no Postgres mas não no Oracle 11g, e reescreve bind variables como concatenação de string porque foi isso que viu na maior parte dos dados de treinamento.
Bom significa fundamentado. A IDE leu seu schema. Sabe que você está no Oracle 19c, não no 23ai, e não oferece operadores de busca vetorial que não existem no seu servidor. Sabe quais índices existem, o que uma restrição diz, como é a assinatura de um pacote na versão que você está usando. Quando gera SQL, gera SQL para o seu banco de dados, não para um hipotético.
Essa fundamentação exige acesso local. Uma ferramenta que envia seu schema para um serviço remoto transferiu a parte difícil da IDE para uma API na nuvem. Pode ainda produzir boas respostas. Mas também colocou o schema da sua produção em um servidor que você não controla.
Local-first não é uma escolha de posicionamento. É a arquitetura que torna a fundamentação honesta.
O critério para “bom” em 2026 não é alto. Conheça o banco de dados. Conheça a versão. Conheça o schema. Não invente o que o banco não tem. Quase nada no mercado passa nesse teste.
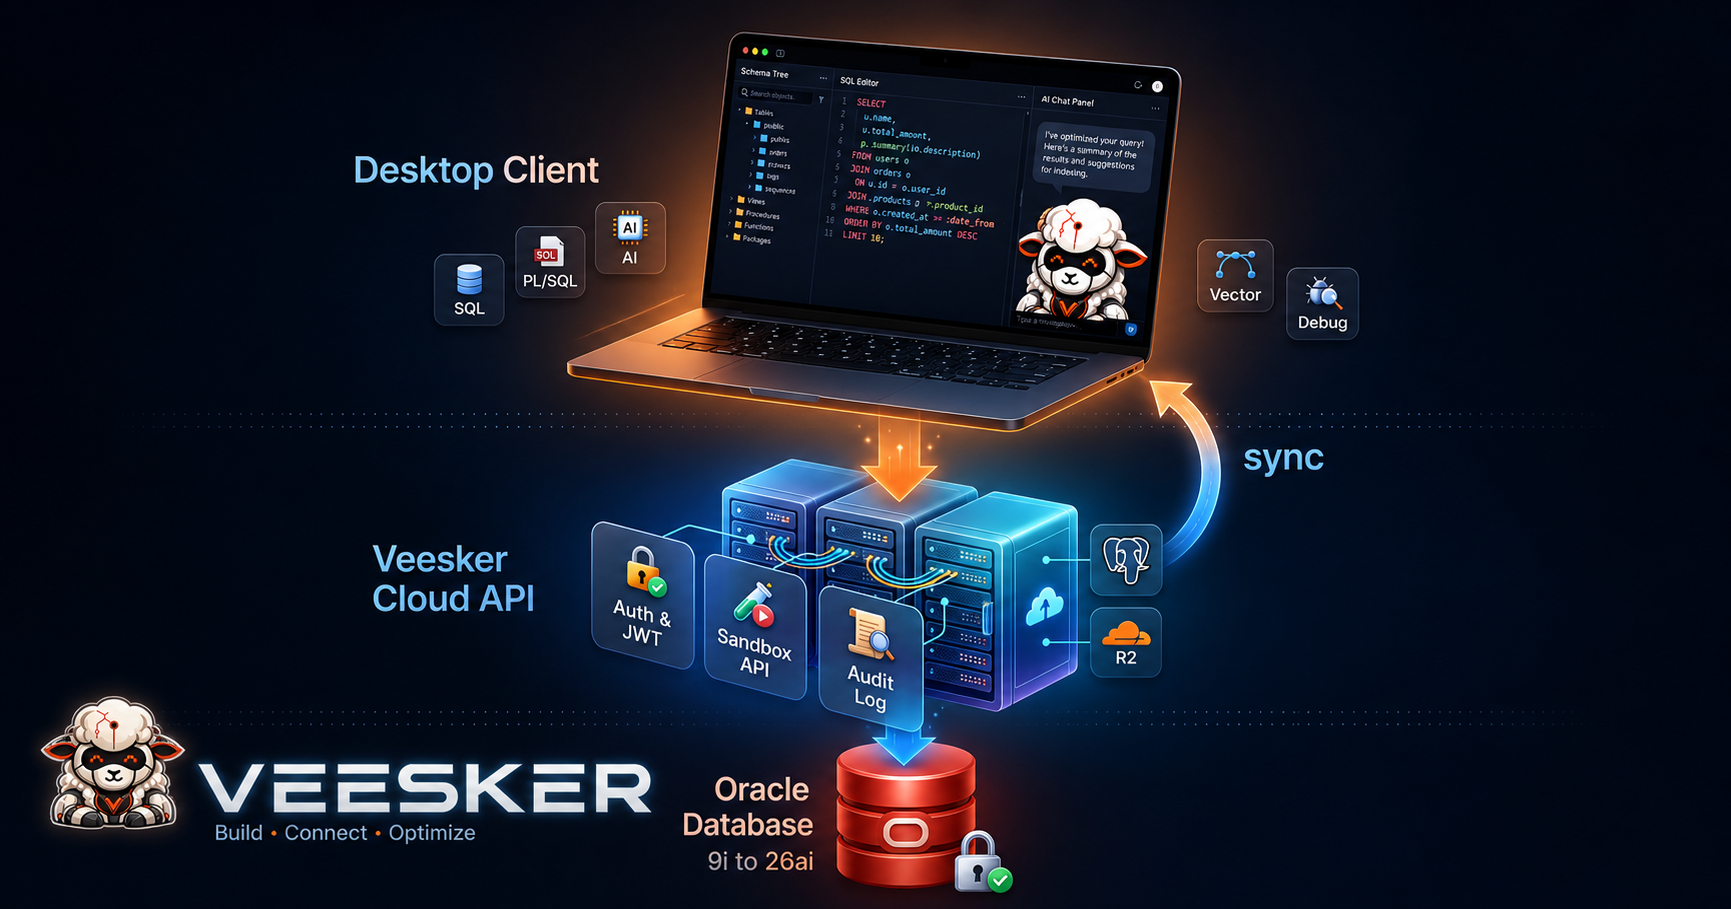
Baixe o Veesker — disponível para Windows, macOS e Linux, conecta ao Oracle 9i até o 26ai sem instalação separada de client, e lê seu schema localmente. A Community Edition é gratuita sob a licença Apache 2.0.
— Veesker